
Vol. 28 - Num. 111
Originales
Inteligencia artificial en el autismo: del cribado al diagnóstico, entre promesas y sesgos algorítmicos
Manuel Antonio Rodríguez Lanzaa, José Luis Aparicio Sánchez a, Aniuska Pilar Sutil Rosasa
aServicio de Pediatría. Hospital Universitario Doctor José Molina Orosa. Arrecife. Las Palmas. España.
Correspondencia: MA Rodríguez. Correo electrónico: mrodlany@gobiernodecanarias.org
Cómo citar este artículo: Rodríguez Lanza MA, Aparicio Sánchez JL, Sutil Rosas AP. Inteligencia artificial en el autismo: del cribado al diagnóstico, entre promesas y sesgos algorítmicos . Rev Pediatr Aten Primaria. 2026;28:[en prensa].
Publicado en Internet: 01-09-2026 - Número de visitas: 451
Resumen
Introducción: el trastorno del espectro autista (TEA) continúa presentando retrasos diagnósticos relevantes en Atención Primaria (AP). La inteligencia artificial (IA) ha emergido como posible herramienta de apoyo al cribado y diagnóstico precoz, aunque su aplicación plantea limitaciones metodológicas y desafíos éticos relacionados con sesgos algorítmicos y modelos de neurodiversidad.
Objetivo: analizar críticamente la evidencia reciente sobre aplicaciones de IA en el TEA, evaluando su rendimiento diagnóstico, sus limitaciones metodológicas y sus implicaciones clínicas y éticas en AP.
Métodos: revisión narrativa estructurada de literatura reciente sobre IA aplicada al TEA en PubMed/MEDLINE, Scopus e IEEE Xplore. Se incluyeron estudios sobre cribado, apoyo diagnóstico, biomarcadores digitales e implicaciones éticas.
Resultados: los modelos de IA muestran resultados prometedores en el cribado y apoyo diagnóstico, especialmente mediante el análisis conductual, procesamiento del lenguaje natural e integración multimodal de datos. Sin embargo, la mayoría de los estudios presentan una validación externa limitada, diseños retrospectivos y una elevada heterogeneidad metodológica. Los rendimientos observados no muestran una superioridad clínica consistente frente a las herramientas convencionales de cribado como M-CHAT-R/F. Persisten, además, riesgos de sesgo relacionados con una representatividad insuficiente, infradiagnóstico en niñas y priorización de métricas centradas en conformidad conductual.
Conclusiones: la IA podría constituir una herramienta complementaria de apoyo en AP, especialmente para la estratificación del riesgo y la priorización de derivaciones, pero la evidencia actual sigue siendo insuficiente para una implementación generalizada. Su integración responsable requiere validación prospectiva, transparencia algorítmica, supervisión clínica permanente y una participación activa de la comunidad autista. La decisión diagnóstica continúa siendo una responsabilidad fundamentalmente humana.
Palabras clave
● Cribado ● Diagnóstico precoz ● Inteligencia artificial ● Neurodiversidad ● Trastorno del espectro autistaINTRODUCCIÓN
El trastorno del espectro autista (TEA) es una condición del neurodesarrollo caracterizada por dificultades persistentes en la comunicación e interacción social, y por la presencia de patrones de comportamiento restrictivos y repetitivos. Su prevalencia estimada en Europa se sitúa en torno a 7,6 por 1000 niños, con cifras similares en España ─entre 7,2 y 9,0 por 1000─ según estudios poblacionales recientes1-3. El aumento sostenido en las tasas de diagnóstico se atribuye, en parte, a la ampliación de los criterios diagnósticos, a una mayor sensibilización profesional y a la mejora de los instrumentos de detección, más que a un incremento real de la incidencia.
A pesar de estos avances, el retraso diagnóstico persiste como problema relevante: la edad media de diagnóstico en muchos sistemas sanitarios occidentales supera los cuatro años4, cuando la intervención temprana podría tener mayor impacto funcional. En Atención Primaria (AP), el pediatra desempeña un papel central en la sospecha inicial, enfrentando limitaciones estructurales de tiempo, heterogeneidad clínica y disponibilidad de recursos especializados. En este contexto, la inteligencia artificial (IA) ha comenzado a incorporarse como una herramienta potencial para mejorar la detección precoz, con aplicaciones que abarcan desde algoritmos de clasificación basados en cuestionarios hasta modelos de aprendizaje profundo aplicados a neuroimagen5-7.
Conviene matizar que el retraso diagnóstico no depende únicamente del momento de la sospecha clínica. También influyen las demoras acumuladas en circuitos especializados, neuropediatría, atención temprana, evaluación neuropsicológica y pruebas complementarias como RMN o estudio genético, que no son imprescindibles para establecer el diagnóstico clínico según DSM-5 ni para iniciar una intervención temprana8,9. Por ello, cualquier valoración de la utilidad real de la IA debería considerar no solo su rendimiento diagnóstico, sino también su capacidad para reducir tiempos en los distintos pasos asistenciales que condicionan el acceso a apoyos.
Sin embargo, el desarrollo tecnológico no puede disociarse de interrogantes éticos fundamentales. Durante décadas, el abordaje dominante del TEA se ha fundamentado en un modelo biomédico que conceptualiza el autismo como patología caracterizada por déficits cuantificables que requieren corrección10,11. Este marco ha orientado las métricas de éxito terapéutico hacia la aproximación a patrones neurotípicos: mayor contacto visual, mejor reciprocidad conversacional y reducción de comportamientos repetitivos. Análisis críticos recientes cuestionan estas premisas, señalando que una narrativa centrada exclusivamente en déficits puede afectar negativamente la autoestima del niño, dificultar la construcción de una identidad positiva y comprometer su salud mental a largo plazo10,11. Entre las consecuencias documentadas se encuentran las estrategias de masking ─supresión consciente de rasgos autistas para conformarse a expectativas sociales─, asociadas con agotamiento emocional crónico, ansiedad elevada y mayor riesgo de depresión12.
Esta tensión adquiere especial relevancia en el contexto de la aplicación de IA al TEA. Si los sistemas aprenden de datos etiquetados según criterios biomédicos tradicionales ─donde el éxito se mide por la aproximación a conductas mayoritarias─ pueden convertirse inadvertidamente en herramientas de normalización, incluso cuando se diseñan con las mejores intenciones clínicas. El presente trabajo analiza críticamente la evidencia disponible sobre aplicaciones de IA en el cribado y diagnóstico del TEA, evalúa sus limitaciones metodológicas y examina las implicaciones éticas de los objetivos algorítmicos, con el fin de orientar una implementación responsable en AP.
MÉTODOS
Se realizó una revisión narrativa estructurada sobre aplicaciones de IA y aprendizaje automático en el cribado, diagnóstico y manejo del TEA, publicadas entre enero de 2018 y el 15 de enero de 2026, en PubMed/MEDLINE, Scopus e IEEE Xplore. La inclusión de IEEE Xplore responde a que una parte relevante de la literatura técnica sobre algoritmos aplicados al TEA se publica en revistas y actas de ingeniería biomédica e informática médica.
Estrategia de búsqueda
Se utilizó la siguiente cadena, adaptada a la sintaxis de cada base de datos:
(“autism spectrum disorder” OR “autism”) AND (“artificial intelligence” OR “machine learning” OR “deep learning”) AND (“screening” OR “diagnosis” OR “assessment” OR “biomarker” OR “electronic health record” OR “neuroimaging” OR “EEG” OR “facial recognition” OR “social behaviour”)
Los términos se aplicaron en el título, el resumen y las palabras clave, con filtros para estudios en humanos y publicaciones en inglés o español, priorizando la población pediátrica. Se complementó con una búsqueda manual de referencias (snowballing) en los artículos más relevantes.
Criterios de selección y extracción de datos
Se incluyeron estudios originales, revisiones sistemáticas y metanálisis sobre el rendimiento de modelos de IA en el cribado, el diagnóstico o la estratificación del TEA, así como trabajos sobre implicaciones éticas e implementación clínica. En la síntesis principal se priorizaron estudios con validación externa o temporal y muestras superiores a 100 participantes; los de menor tamaño se incluyeron cuando aportaban valor conceptual, metodológico o ético en áreas emergentes (biomarcadores digitales, neuroimagen, robótica terapéutica).
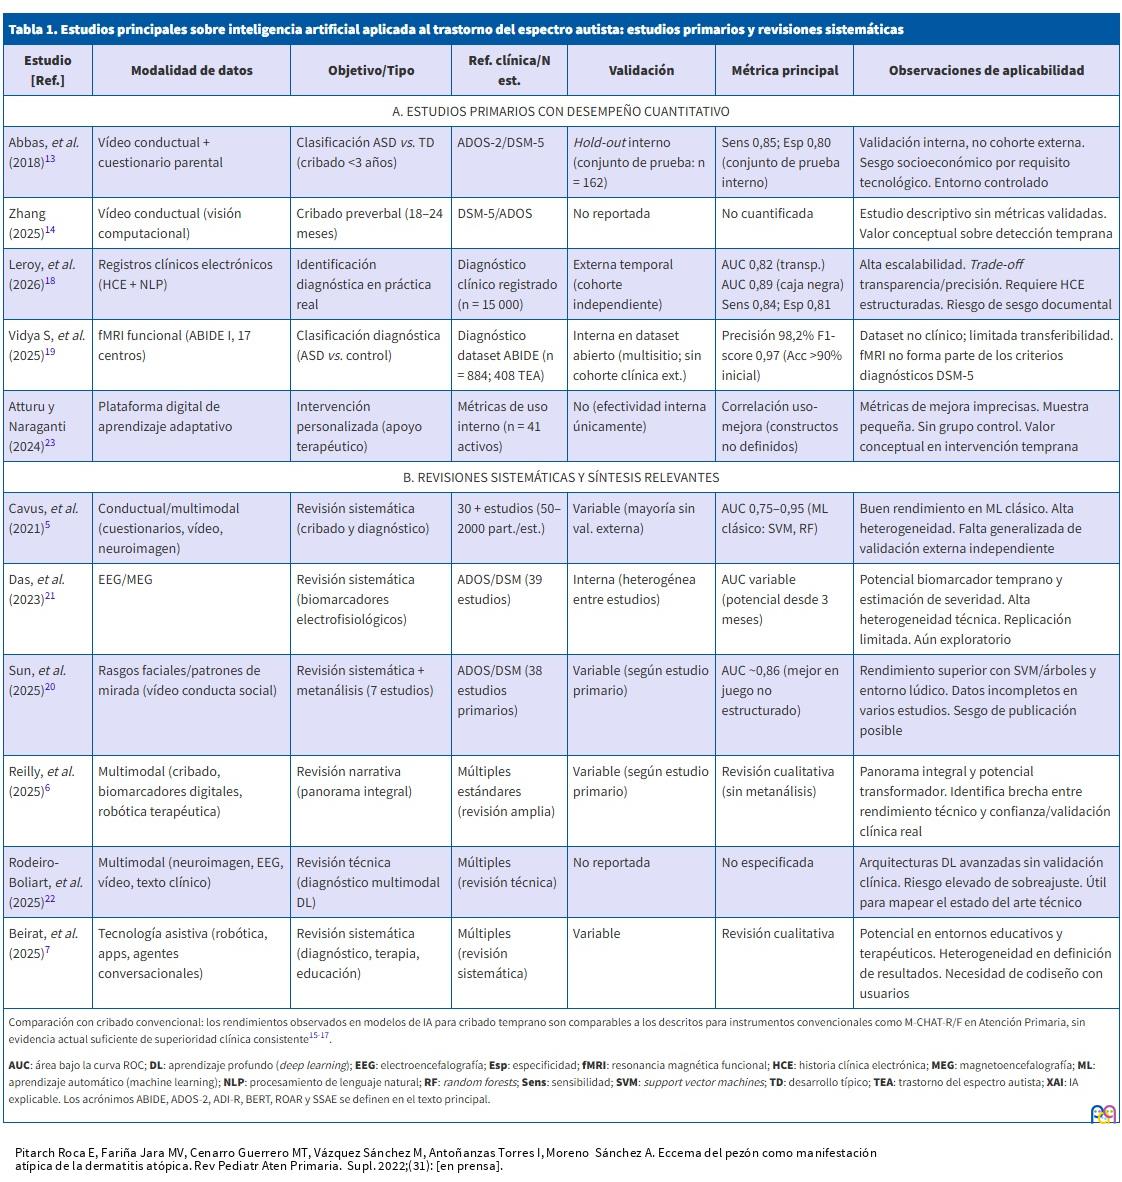
De los 47 artículos incluidos, se seleccionaron 10 referencias principales para la Tabla 1, atendiendo a la calidad metodológica, la diversidad en el tipo de datos empleados, la representatividad de arquitecturas de IA y la inclusión del análisis ético. La selección se realizó por lectura secuencial de títulos y resúmenes y revisión a texto completo, con una segunda lectura independiente de los resúmenes para minimizar los sesgos de selección. De cada estudio se extrajeron: tipo de datos, objetivo del modelo, referencia clínica, tipo de validación y métricas de rendimiento.
| Tabla 1. Estudios principales sobre inteligencia artificial aplicada al trastorno del espectro autista: estudios primarios y revisiones sistemáticas | ||||||
|---|---|---|---|---|---|---|
| Estudio [Ref.] | Modalidad de datos | Objetivo/Tipo | Ref. clínica/N est. | Validación | Métrica principal | Observaciones de aplicabilidad |
| A. ESTUDIOS PRIMARIOS CON DESEMPEÑO CUANTITATIVO | ||||||
| Abbas, et al. (2018)13 | Vídeo conductual + cuestionario parental | Clasificación ASD vs. TD (cribado <3 años) | ADOS-2/DSM-5 | Hold-out interno (conjunto de prueba: n = 162) | Sens 0,85; Esp 0,80 (conjunto de prueba interno) | Validación interna, no cohorte externa. Sesgo socioeconómico por requisito tecnológico. Entorno controlado |
| Zhang (2025)14 | Vídeo conductual (visión computacional) | Cribado preverbal (18–24 meses) | DSM-5/ADOS | No reportada | No cuantificada | Estudio descriptivo sin métricas validadas. Valor conceptual sobre detección temprana |
| Leroy, et al. (2026)18 | Registros clínicos electrónicos (HCE + NLP) | Identificación diagnóstica en práctica real | Diagnóstico clínico registrado (n = 15 000) | Externa temporal (cohorte independiente) | AUC 0,82 (transp.) AUC 0,89 (caja negra) Sens 0,84; Esp 0,81 | Alta escalabilidad. Trade-off transparencia/precisión. Requiere HCE estructuradas. Riesgo de sesgo documental |
| Vidya S, et al. (2025)19 | fMRI funcional (ABIDE I, 17 centros) | Clasificación diagnóstica (ASD vs. control) | Diagnóstico dataset ABIDE (n = 884; 408 TEA) | Interna en dataset abierto (multisitio; sin cohorte clínica ext.) | Precisión 98,2% F1-score 0,97 (Acc >90% inicial) | Dataset no clínico; limitada transferibilidad. fMRI no forma parte de los criterios diagnósticos DSM-5 |
| Atturu y Naraganti (2024)23 | Plataforma digital de aprendizaje adaptativo | Intervención personalizada (apoyo terapéutico) | Métricas de uso interno (n = 41 activos) | No (efectividad interna únicamente) | Correlación uso-mejora (constructos no definidos) | Métricas de mejora imprecisas. Muestra pequeña. Sin grupo control. Valor conceptual en intervención temprana |
| B. REVISIONES SISTEMÁTICAS Y SÍNTESIS RELEVANTES | ||||||
| Cavus, et al. (2021)5 | Conductual/multimodal (cuestionarios, vídeo, neuroimagen) | Revisión sistemática (cribado y diagnóstico) | 30 + estudios (50–2000 part./est.) | Variable (mayoría sin val. externa) | AUC 0,75–0,95 (ML clásico: SVM, RF) | Buen rendimiento en ML clásico. Alta heterogeneidad. Falta generalizada de validación externa independiente |
| Das, et al. (2023)21 | EEG/MEG | Revisión sistemática (biomarcadores electrofisiológicos) | ADOS/DSM (39 estudios) | Interna (heterogénea entre estudios) | AUC variable (potencial desde 3 meses) | Potencial biomarcador temprano y estimación de severidad. Alta heterogeneidad técnica. Replicación limitada. Aún exploratorio |
| Sun, et al. (2025)20 | Rasgos faciales/patrones de mirada (vídeo conducta social) | Revisión sistemática + metanálisis (7 estudios) | ADOS/DSM (38 estudios primarios) | Variable (según estudio primario) | AUC ~0,86 (mejor en juego no estructurado)
|
Rendimiento superior con SVM/árboles y entorno lúdico. Datos incompletos en varios estudios. Sesgo de publicación posible |
| Reilly, et al. (2025)6 | Multimodal (cribado, biomarcadores digitales, robótica terapéutica) | Revisión narrativa (panorama integral) | Múltiples estándares (revisión amplia) | Variable (según estudio primario) | Revisión cualitativa (sin metanálisis) | Panorama integral y potencial transformador. Identifica brecha entre rendimiento técnico y confianza/validación clínica real |
| Rodeiro-Boliart, et al. (2025)22 | Multimodal (neuroimagen, EEG, vídeo, texto clínico) | Revisión técnica (diagnóstico multimodal DL) | Múltiples (revisión técnica) | No reportada | No especificada | Arquitecturas DL avanzadas sin validación clínica. Riesgo elevado de sobreajuste. Útil para mapear el estado del arte técnico |
| Beirat, et al. (2025)7 | Tecnología asistiva (robótica, apps, agentes conversacionales) | Revisión sistemática (diagnóstico, terapia, educación) | Múltiples (revisión sistemática) | Variable | Revisión cualitativa | Potencial en entornos educativos y terapéuticos. Heterogeneidad en definición de resultados. Necesidad de codiseño con usuarios |
|
Comparación con cribado convencional: los rendimientos observados en modelos de IA para cribado temprano son comparables a los descritos para instrumentos convencionales como M-CHAT-R/F en Atención Primaria, sin evidencia actual suficiente de superioridad clínica consistente15-17. AUC: área bajo la curva ROC; DL: aprendizaje profundo (deep learning); EEG: electroencefalografía; Esp: especificidad; fMRI: resonancia magnética funcional; HCE: historia clínica electrónica; MEG: magnetoencefalografía; ML: aprendizaje automático (machine learning); NLP: procesamiento de lenguaje natural; RF: random forests; Sens: sensibilidad; SVM: support vector machines; TD: desarrollo típico; TEA: trastorno del espectro autista; XAI: IA explicable. Los acrónimos ABIDE, ADOS-2, ADI-R, BERT, ROAR y SSAE se definen en el texto principal. |
||||||
Selección de estudios
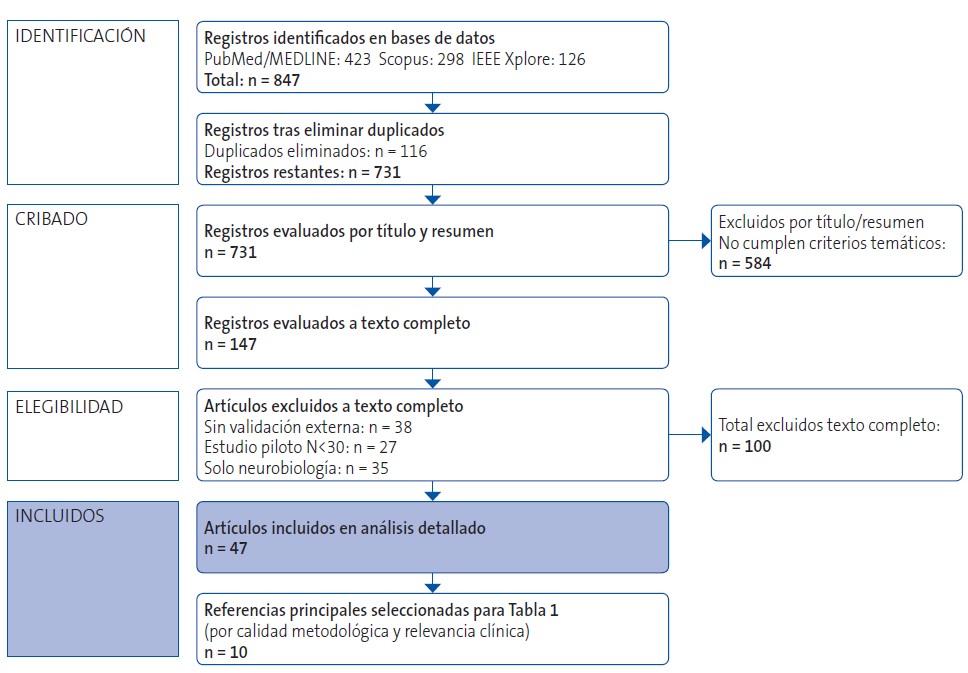
El proceso se describe en la Figura 1. La búsqueda identificó 847 registros (PubMed/MEDLINE: 423; Scopus: 298; IEEE Xplore: 126). Tras eliminar duplicados (n = 116) y excluir por título/resumen (n = 584), se evaluaron 147 a texto completo, resultando 47 artículos incluidos.
| Figura 1. Diagrama de flujo del proceso de selección de estudios |
|---|
 |
Evaluación crítica y síntesis
No se aplicó una herramienta formal de riesgo de sesgo (por ejemplo, QUADAS-2). Los estudios se analizaron según dominios conceptuales predefinidos: selección de participantes, definición del índice diagnóstico, referencia clínica, tipo de validación y aplicabilidad clínica real. La evidencia técnica se integró con literatura sobre neurodiversidad y modelos biopsicosociales10,11, así como estudios sobre masking social12 para evaluar no solo el rendimiento de los sistemas, sino también los objetivos clínicos que optimizan y sus implicaciones para AP.
RESULTADOS
De los 47 artículos incluidos en el análisis detallado, la mayoría correspondían a estudios de rendimiento diagnóstico (n = 31), seguidos de revisiones sistemáticas y metanálisis (n = 11) y análisis éticos o de implicaciones clínicas (n = 5). Las aplicaciones se distribuían entre cribado temprano (n = 19), apoyo al diagnóstico en fase confirmatoria (n = 22) e intervención personalizada (n = 6). A continuación, se describen los hallazgos principales organizados por tipo de aplicación, fuente de datos y tipo de modelo de IA. Las características de los estudios clave se sintetizan en la Tabla 1.
Cribado temprano
Los estudios de cribado priorizan una alta sensibilidad para minimizar casos no detectados, aceptando cierta tasa de falsos positivos que se filtrarán en la evaluación especializada posterior. Abbas et al.13 demostraron sensibilidad del 85% y especificidad del 80% en el cribado temprano en menores de 3 años, combinando análisis de vídeo domiciliario y cuestionarios parentales; estas métricas proceden de una partición de validación (hold-out) interna del mismo dataset, con 162 niños en el conjunto de prueba. Zhang14 describe sistemas similares orientados a la detección en fase preverbal (18-24 meses) mediante visión computacional aplicada a microexpresiones faciales y patrones de mirada, aunque sin reportar métricas cuantitativas validadas.
Un aspecto crítico para la interpretación de estas cifras es su comportamiento en contextos de baja prevalencia. Asumiendo una prevalencia poblacional de TEA del 1-2% en población pediátrica general, los valores reportados por Abbas et al.13 ─sensibilidad 85%, especificidad 80%, en validación hold-out interna─ generan un valor predictivo positivo estimado de entre el 4 y el 8%. Esto implica que, en un escenario de cribado poblacional, la mayoría de las derivaciones producidas por el algoritmo corresponderían a falsos positivos, con las consiguientes implicaciones organizativas ─presión sobre unidades especializadas ya saturadas─ y emocionales para las familias. Este comportamiento no constituye un fallo técnico del algoritmo, sino una consecuencia estadística inherente al cribado en poblaciones de baja prevalencia, y debe tenerse en cuenta al diseñar cualquier estrategia de implementación en AP.
Estas cifras adquieren su verdadero significado cuando se contrastan con el rendimiento del instrumento de cribado actualmente recomendado en AP, el M-CHAT-R/F. La evidencia disponible muestra valores diagnósticos en el mismo rango: el estudio multicéntrico español de Canal-Bedia et al. reporta una sensibilidad del 81% y una especificidad del 99% (LR+ 81; LR− 0,19)15; el metanálisis de Wieckowski et al. describe valores agregados de sensibilidad del 83% y especificidad del 94% (LR+ 13,8; LR− 0,18)16; y Aishworiya et al. documentan, en un estudio pragmático en AP, una sensibilidad del 82% pero una especificidad notablemente inferior (45%) en cribado poblacional indiscriminado (LR+ 1,84; LR− 0,38)17. La lectura conjunta es clara: en el escenario actual, los modelos de IA basados en vídeo conductual y cuestionarios parentales no superan al M-CHAT-R/F en sensibilidad ni en especificidad, y reproducen el mismo problema estructural de bajo valor predictivo positivo cuando se aplican como cribado universal. La ventaja potencial de la IA en este nivel no reside, por tanto, en mejorar las métricas básicas, sino en aspectos complementarios: capacidad de detección en fases preverbales (18-24 meses), reducción de la dependencia del reporte parental subjetivo, escalabilidad mediante análisis automatizado de vídeo domiciliario y posibilidad de aplicarse como segundo filtro tras un M-CHAT-R/F positivo para refinar la priorización de derivaciones. Esta función de control de calidad ─orientada a reducir falsos negativos del cribado convencional, especialmente en niñas con mayor capacidad de masking─ resulta clínicamente más plausible que un reemplazo del cribado tradicional.
Apoyo al diagnóstico y estratificación en fase confirmatoria
En esta fase el énfasis se desplaza hacia la especificidad, con el objetivo de reducir falsos positivos y evitar diagnósticos incorrectos. Conviene distinguir, sin embargo, dos tipos de aplicación cualitativamente distintos, que comparten el contexto asistencial de la fase confirmatoria, pero difieren en su relación con el acto diagnóstico clínico y en su potencial de transferibilidad.
Apoyo escalable mediante HCE y NLP. Leroy et al.18 aplicaron procesamiento de lenguaje natural (NLP, Natural Language Processing) a notas clínicas de 15 000 pacientes procedentes de historias clínicas electrónicas (HCE), alcanzando un área bajo la curva (AUC) de 0,82 con modelos transparentes frente a 0,89 con modelos de caja negra ─ambas métricas obtenidas en cohorte de validación externa temporal independiente, conforme a la versión publicada del artículo─. Este sistema no sustituye ni emula el acto diagnóstico clínico ─basado en la evaluación directa según DSM-5 y herramientas como ADOS-2 o ADI-R─, sino que opera sobre registros documentales previos para identificar casos probables que han podido pasar inadvertidos en el circuito asistencial. Su valor reside precisamente en esa escalabilidad: puede aplicarse de forma retrospectiva sobre grandes volúmenes de HCE sin requerir intervención clínica adicional. La validación externa temporal refuerza su solidez, aunque la aplicabilidad queda condicionada a la disponibilidad de sistemas HCE estructurados. El resultado evidencia, además, un trade-off relevante entre precisión y explicabilidad que tiene implicaciones directas para la implementación clínica.
Biomarcadores y neuroimagen: alta métrica, baja transferibilidad. En un plano conceptualmente diferente, Vidya S et al.19 desarrollaron un modelo de aprendizaje profundo (deep learning, DL) aplicado a datos de conectividad funcional obtenidos mediante resonancia magnética funcional (fMRI) del dataset ABIDE I, que incluyó 884 participantes (408 con TEA y 476 controles) procedentes de 17 centros internacionales. El modelo alcanzó una precisión del 98,2% (F1-score: 0,97) ─métricas obtenidas en validación interna dentro del propio dataset ABIDE I, sin cohortes clínicas externas independientes─, incorporando un marco de inteligencia artificial explicable (XAI) e identificando Integrated Gradients como el enfoque más robusto. Estas cifras deben leerse con cautela: la fMRI no forma parte de los criterios diagnósticos del DSM-5, y la validación exclusivamente interna limita la extrapolación a entornos asistenciales reales. El resultado ilustra con claridad la brecha entre rendimiento técnico en datasets de investigación y transferibilidad clínica, un patrón recurrente en la literatura sobre biomarcadores digitales aplicados al TEA. Es importante precisar el papel de la neuroimagen y la electroencefalografía en esta revisión. Ninguna prueba complementaria (fMRI, electroencefalograma [EEG], magnetoencefalografía [MEG], estructura cerebral, genética) forma parte de los criterios diagnósticos del DSM-5 ni dispone de valor predictivo clínicamente establecido para el TEA, y ninguna se recomienda actualmente en el circuito asistencial de AP. Su inclusión en este trabajo no obedece, por tanto, a una propuesta de uso clínico, sino al hecho de que constituyen el bloque cuantitativamente más relevante de la literatura técnica reciente sobre IA aplicada al TEA, y a su valor ilustrativo: muestran con claridad la disociación entre cifras de rendimiento muy elevadas en datasets cerrados y utilidad clínica real, y permiten al pediatra de AP interpretar críticamente este tipo de publicaciones cuando aparezcan referenciadas en contextos divulgativos o promocionales. En el horizonte clínico inmediato, el peso de la IA aplicable a AP recae en las modalidades basadas en vídeo conductual, cuestionarios y HCE, no en las pruebas de neuroimagen ni electrofisiológicas.
Rendimiento según el tipo de datos
Los modelos basados en cuestionarios combinados con aprendizaje automático (ML, machine learning) clásico reportan AUC en el rango 0,75-0,95 en validación interna con heterogeneidad metodológica considerable entre estudios5. El análisis de vídeo conductual ofrece la ventaja de capturar comportamiento en contextos naturales y permite la detección en fases preverbales ─sensibilidad 85%, especificidad 80%, obtenidas en validación hold-out interna13─, aunque requiere vídeos de calidad técnica suficiente y plantea cuestiones sustantivas de privacidad.
De forma consistente, una revisión sistemática reciente con metanálisis centrada en algoritmos de IA para el seguimiento de conductas sociales durante interacciones naturales ─principalmente rasgos faciales y patrones de mirada─ mostró un rendimiento diagnóstico global elevado (AUC ~0,86 en promedio ponderado de estudios primarios), con variabilidad significativa entre estudios20. El rendimiento fue superior cuando se emplearon características faciales y en entornos de juego no estructurado, y los modelos basados en SVM (máquinas de soporte vectorial, del inglés Support Vector Machine) y algoritmos de tipo árbol mostraron una base empírica relativamente más consistente. No obstante, la heterogeneidad metodológica, el uso frecuente de muestras pequeñas y la limitada validación en poblaciones diversas condicionan su aplicabilidad clínica y refuerzan la necesidad de estandarización y validación externa independiente antes de una implementación generalizable.
El procesamiento de lenguaje natural aplicado a HCE ofrece escalabilidad, con AUC entre 0,82 y 0,89 en validación externa temporal18, aunque su rendimiento depende de la estandarización de los registros en HCE. Los modelos de aprendizaje profundo (DL, Deep Learning) aplicados a neuroimagen alcanzan precisiones elevadas en datasets de investigación en validación interna19, pero presentan coste prohibitivo y ausencia de validación prospectiva en entornos asistenciales reales.
En el ámbito electrofisiológico, una revisión sistemática reciente de modelos de aprendizaje automático aplicados a electroencefalografía (EEG) y magnetoencefalografía (MEG) identificó 39 estudios, con predominio de SVM y, en menor medida, redes neuronales profundas21. Los resultados sugieren capacidad discriminativa elevada y potencial para predicción en lactantes de alto riesgo desde los 3 meses de edad, así como estimación de severidad sintomática. Sin embargo, los autores enfatizan la heterogeneidad metodológica y la necesidad de estudios de replicación y validación externa independiente antes de su traslación clínica.
Tipos de modelos de IA y explicabilidad
Las revisiones sistemáticas analizadas5-7 describen una evolución desde algoritmos de aprendizaje automático clásico ─Support Vector Machines (SVM), Random Forests (RF), regresión logística─ hacia arquitecturas de aprendizaje profundo multimodal que integran múltiples fuentes de datos sin necesidad de ingeniería manual de características22. La explicabilidad algorítmica emerge como un requisito crítico para la adopción en práctica clínica. El trabajo de Vidya S et al.19 representa el ejemplo más completo analizado, al comparar sistemáticamente múltiples técnicas XAI. La diferencia de 0,07 puntos de AUC entre modelo de caja negra y modelo interpretable documentada por Leroy et al.18 puede justificar la elección del modelo explicable sin pérdida asistencial relevante.
Intervención personalizada y tecnología asistiva
En el ámbito de las intervenciones basadas en IA, la evidencia disponible es aún incipiente. Atturu y Naraganti23 evaluaron un sistema de aprendizaje individualizado en 41 usuarios activos con una edad media de 3,5 años, observando una asociación entre el uso de la plataforma y la mejora en los resultados reportados. El formato de comunicación breve limita el acceso al diseño metodológico completo, por lo que no es posible valorar con solidez qué constructos miden las métricas de mejora empleadas ni la magnitud real del efecto. Beirat et al.7 destacan el potencial de estas herramientas en contextos educativos y terapéuticos, subrayando la necesidad de codiseño con usuarios y familias.
Limitaciones metodológicas transversales
Independientemente del tipo de datos o arquitectura empleada, los estudios analizados comparten limitaciones metodológicas de carácter transversal: predominio de diseños retrospectivos sobre bases de datos secundarias, con escasos estudios prospectivos6,22; sesgo de representatividad en muestras de entrenamiento, con predominio de participantes varones5-7 y cohortes procedentes de contextos occidentales de nivel socioeconómico medio-alto; y heterogeneidad en las métricas de resultado ─AUC, sensibilidad, especificidad, precisión, F1-score─ que dificulta la comparación directa entre estudios y la síntesis cuantitativa de la evidencia5,6.
DISCUSIÓN
Los sistemas de inteligencia artificial aplicados al TEA alcanzan rendimientos diagnósticos prometedores en entornos controlados, especialmente en aproximaciones multimodales que combinan cuestionarios, vídeo conductual y análisis de historias clínicas electrónicas5,13,18. No obstante, la interpretación de estas métricas exige una contextualización clínica y metodológica rigurosa antes de plantear su adopción en AP.
Limitaciones metodológicas y de generalización
La heterogeneidad metodológica entre estudios es considerable: las revisiones sistemáticas describen una amplia variabilidad en tamaño muestral, selección de variables, definición de outcomes y procedimientos de validación, con una proporción relevante carente de validación externa independiente y predominio de diseños retrospectivos sobre bases de datos secundarias5-7. Esto limita la generalización a poblaciones distintas de las del entrenamiento e impide determinar si la implementación sistemática de IA reduce la edad diagnóstica o mejora los resultados funcionales a medio y largo plazo. La probabilidad preprueba de TEA en AP es sustancialmente menor que en las cohortes reclutadas en unidades especializadas, lo que amplifica las limitaciones de transferibilidad.
Desde la perspectiva del cribado, incluso modelos con sensibilidad y especificidad elevadas generan un volumen importante de falsos positivos en contextos de baja prevalencia. Este comportamiento no es exclusivo de la IA: instrumentos convencionales como el M-CHAT-R/F presentan limitaciones similares en contextos de baja probabilidad preprueba. La IA no elimina este problema estadístico; puede, en cambio, complementar el cribado convencional si se diseña para operar en el paso previo a la derivación, estratificando el riesgo dentro de la población ya seleccionada por instrumentos clínicos estándar, en lugar de aplicarse de forma indiscriminada sobre la población general.
Este planteamiento se conecta directamente con los principios de la prevención cuaternaria, entendida como el conjunto de acciones dirigidas a evitar, reducir o paliar el daño producido por la propia intervención sanitaria, especialmente cuando se sobreutilizan pruebas o circuitos de derivación en poblaciones de bajo riesgo24. Cualquier estrategia de cribado mediante IA en AP debe contemplar no solo los verdaderos positivos detectados, sino también los falsos positivos ─con su carga emocional, organizativa y de iatrogenia diagnóstica─ y las detecciones algorítmicas cuya identificación precoz no se traduce necesariamente en un beneficio funcional demostrado.
A ello se suma el “efecto cascada” que toda detección automatizada activa en el sistema sanitario: pruebas complementarias secundarias (resonancia magnética nuclear [RMN], estudio genético, evaluaciones neuropsicológicas en serie), derivaciones a múltiples niveles especializados y un consumo creciente de recursos terapéuticos cuya pertinencia individual no siempre es proporcional al riesgo real del niño cribado. Movimientos asistenciales como Choosing Wisely o la iniciativa española “No hacer”/“Menos es más”, promovidas por sociedades científicas para identificar prácticas de bajo valor clínico, ofrecen un marco conceptual útil con el que la implementación de IA debería ser coherente: la utilidad clínica probablemente dependa menos de ampliar indiscriminadamente el cribado y más de mejorar la precisión y contextualización de las estrategias ya existentes a quienes ya presentan signos de sospecha clínica25. Esta perspectiva no invalida el desarrollo de la IA en el ámbito del TEA, pero sí redefine su lugar legítimo: el de un filtro estratificador que se aplica después del juicio clínico y nunca antes de él.
Representatividad, sesgos en modelos de IA y equidad diagnóstica
La representatividad de las muestras de entrenamiento constituye uno de los problemas más relevantes: las revisiones sistemáticas señalan el predominio de participantes varones5-7 y de cohortes occidentales de nivel socioeconómico medio-alto5,22, lo que compromete el rendimiento en fenotipos clínicos menos representados y perpetúa disparidades diagnósticas por sexo y origen. Los modelos aprenden de datos etiquetados según criterios biomédicos tradicionales; si esos datos proceden de poblaciones donde se ha subdiagnosticado a niñas autistas con mayor capacidad de masking social, los algoritmos reproducirán y amplificarán ese sesgo. Su mitigación requiere la participación de personas autistas en el desarrollo y la evaluación de estas herramientas, coherente con el principio “nada sobre nosotros sin nosotros”26, especialmente pertinente cuando la tecnología influye en circuitos diagnósticos, priorización de recursos y métricas de resultado7,10.
Implicaciones éticas: qué optimizan los algoritmos
La cuestión ética central trasciende el rendimiento técnico y apunta a los objetivos implícitos de los sistemas analizados. El abordaje dominante del TEA se ha fundamentado en un modelo biomédico que conceptualiza el autismo como conjunto de déficits cuantificables que requieren corrección10,11. Cuando los algoritmos se diseñan sin una definición explícita de sus objetivos clínicos y sin participación de la comunidad autista, existe el riesgo de que prioricen indicadores visibles de ajuste conductual ─contacto visual, reducción de conductas autoestimulatorias, reciprocidad conversacional─ e incentiven estrategias de masking social, asociadas en estudios observacionales con mayor ansiedad, agotamiento emocional y sintomatología depresiva12. Frente a este paradigma, la literatura emergente propone métricas alternativas más pertinentes: reducción de la sobrecarga familiar, acceso efectivo a apoyos adecuados al perfil individual, calidad de vida autodefinida por la propia persona autista y reducción del tiempo hasta el diagnóstico en grupos infradiagnosticados ─en particular niñas y poblaciones de nivel socioeconómico bajo─. Incorporar estas dimensiones como criterios de éxito no es solo una demanda ética, sino una condición para que la IA contribuya a reducir inequidades en lugar de ampliarlas.
La explicabilidad algorítmica adquiere aquí una dimensión adicional. Como demuestra Vidya S et al.19, es posible interrogar qué define el modelo como “atípico” e identificar las regiones cerebrales o patrones conductuales que orientan la clasificación. El trade-off entre precisión y transparencia documentado por Leroy et al.18 ─una diferencia de 0,07 puntos de AUC entre modelo de caja negra e interpretable─ es en muchos contextos clínicos un coste asumible a cambio de mayor explicabilidad.
Implementación responsable en Atención Primaria
En el estado actual de la evidencia, no existen datos sólidos que justifiquen sustituir herramientas clínicas estructuradas ni el entrenamiento observacional del profesional de AP por sistemas automatizados de cribado. Desde una perspectiva clínica, la IA debe concebirse exclusivamente como una herramienta de apoyo complementario a la decisión, nunca como sustituta del juicio profesional. Todos los estudios revisados asumen supervisión clínica humana; por el contrario, todos subrayan la necesidad de supervisión humana y de integración contextualizada de los resultados6,7,22. El algoritmo puede aportar una probabilidad o señalar un patrón, pero la decisión de derivación y el encuadre clínico deben basarse en la historia completa del niño, el contexto familiar y la exploración directa.
La implementación real plantea también dilemas de gobernanza del dato. El uso de IA en TEA implica el procesamiento de información especialmente sensible en población pediátrica ─vídeos de comportamiento, audio de interacciones, historias clínicas─ cuya gestión debe alinearse con el Reglamento General de Protección de Datos (RGPD) y la normativa nacional aplicable. Son condiciones no negociables: consentimiento informado explícito, derecho al olvido, auditoría periódica independiente del rendimiento real del algoritmo y transparencia ante las familias. La implementación gradual con monitorización del impacto es preferible a un despliegue masivo sin evaluación prospectiva.
En el estado actual de la evidencia, la evaluación clínica realizada por profesionales entrenados continúa siendo el estándar fundamental del cribado inicial en AP. El entrenamiento sistemático de pediatras, residentes, enfermería pediátrica y profesionales de la educación mediante estancias en centros de atención temprana, escuelas infantiles inclusivas o unidades de neurodesarrollo ─donde puedan observar y participar en el juego con niños neurodivergentes─ es una estrategia actualmente más accesible y clínicamente consolidada que el despliegue masivo de algoritmos sobre vídeos domiciliarios, y aporta además beneficios difícilmente reproducibles por la tecnología: empatía clínica, sensibilidad cultural y comprensión vivencial de las familias. Sin embargo, este modelo formativo encuentra limitaciones logísticas ─disponibilidad de plazas, tiempo asistencial, dispersión geográfica─ que la IA podría contribuir a paliar de forma complementaria. Una línea de desarrollo prometedora, aún apenas explorada en la literatura, es la generación con IA de avatares o personajes virtuales con presentaciones conductuales variadas dentro del espectro autista, dirigidos al entrenamiento de profesionales mediante simulación clínica reproducible. Estos “simuladores TEA” permitirían exposición controlada a fenotipos heterogéneos ─incluyendo presentaciones femeninas, perfiles con elevado masking social y comorbilidades frecuentes─, frente a una formación clínica que necesariamente depende de los casos que el azar asistencial proporciona. Esta aplicación de la IA es probablemente más realista y eficiente, a corto plazo, que su uso como cribador autónomo de población pediátrica general, y se alinea mejor con la prioridad de fortalecer el juicio clínico humano. En cualquier despliegue formativo basado en vídeo ─real o sintético─, la custodia, anonimización y trazabilidad del material deben cumplir los estándares más estrictos de protección de datos pediátricos.
Fortalezas neurocognitivas, modelo biopsicosocial y agenda de investigación
El reconocimiento de las fortalezas neurocognitivas específicas de cada niño ─atención al detalle, pensamiento sistemático, memoria visual, intereses intensos─ puede enriquecer el enfoque clínico y orientar apoyos individualizados, especialmente cuando se integra con dimensiones como teoría de la mente, funciones ejecutivas y coherencia central27, y con factores frecuentes como hipersensibilidad sensorial28 y comorbilidades psiquiátricas29. El marco biopsicosocial y la CIF ofrecen una vía práctica para integrar necesidades, limitaciones y adaptaciones sin reducir el abordaje a una única dimensión30.
Más allá de la clasificación binaria caso/control, los modelos computacionales basados en aprendizaje automático no supervisado pueden contribuir a caracterizar dimensionalmente el espectro, descubrir subgrupos con significado neurobiológico y modelar trayectorias longitudinales del neurodesarrollo, orientando intervenciones más individualizadas31. Esta dimensión, aun escasamente representada en la literatura clínica aplicada al TEA, constituye una de las líneas de mayor potencial traslacional. Las limitaciones conocidas de los instrumentos tradicionales como el M-CHAT-R/F o la CARS ─dependencia del reporte parental, disponibilidad de evaluadores entrenados, interpretación culturalmente condicionada32─ pueden complementarse con IA si se integra de forma estructurada, sin olvidar que la identificación temprana automatizada conlleva también riesgos documentados de sobrediagnóstico y etiquetado33.
Limitaciones del presente estudio
Esta revisión presenta limitaciones inherentes a su diseño narrativo: ausencia de protocolo registrado a priori y de evaluación formal del riesgo de sesgo (por ejemplo, QUADAS-2), selección realizada por un único autor ─mitigada parcialmente por una segunda lectura de resúmenes pero no equivalente a doble extracción─, heterogeneidad en la calidad de las fuentes citadas, y posible omisión de trabajos publicados tras la fecha de búsqueda en un campo de rápida evolución.
Agenda de investigación y condiciones para la implementación
La agenda de investigación debería priorizar estudios prospectivos multicéntricos con validación en entornos reales de AP, análisis coste-efectividad en sistemas públicos y auditorías de sesgo por subgrupos ─sexo, edad y origen socioeconómico─ antes de cualquier implementación generalizada6,22. El valor real de la IA dependerá menos de la mejora marginal de una métrica aislada y más de su integración responsable en procesos clínicos, con supervisión humana y evaluación de impacto en resultados relevantes para pacientes y sistema sanitario.
CONCLUSIONES
La inteligencia artificial aplicada al TEA ofrece oportunidades reales para mejorar el cribado precoz y apoyar el proceso diagnóstico en AP. Los modelos disponibles muestran rendimientos prometedores en entornos controlados y podrían contribuir a optimizar la priorización de derivaciones y el acceso temprano a intervenciones. Sin embargo, la evidencia actual es aún preliminar para su implementación asistencial generalizada: predominan los diseños retrospectivos, la validación externa independiente es escasa, y los estudios prospectivos en entornos reales de AP son prácticamente inexistentes. Esta brecha entre rendimiento técnico y transferibilidad clínica debe ser el punto de partida de cualquier decisión de implementación.
Persiste, además, una cuestión de fondo que esta revisión ha situado en el centro del análisis: la tensión entre sistemas que evalúan el progreso en función de la aproximación a patrones conductuales mayoritarios y enfoques que reconocen el autismo como expresión de diversidad neurocognitiva. Cuando los algoritmos se entrenan con datos etiquetados según criterios biomédicos tradicionales y sin participación de la comunidad autista, existe el riesgo de que prioricen indicadores de ajuste conductual e incentiven estrategias de masking que se asocian con consecuencias negativas para la salud mental a largo plazo. Las métricas de éxito deben incorporar indicadores de bienestar, reducción de sobrecarga familiar, acceso a apoyos y calidad de vida autodefinida, no solo conformidad conductual.
Su integración responsable en la práctica asistencial requiere condiciones claras: validación prospectiva rigurosa en poblaciones diversas, transparencia algorítmica, regulación estricta en materia de privacidad y protección de datos de menores, formación específica de los profesionales, y participación activa de personas autistas en el diseño y supervisión de estas tecnologías. El propósito final debe ser reducir inequidades, reforzar el juicio clínico y promover una atención centrada en la persona y respetuosa con la diversidad neurocognitiva. El pediatra debe mantenerse como garante del proceso diagnóstico, integrando los resultados algorítmicos en el contexto clínico individual de cada familia. La IA puede aportar información valiosa; la decisión clínica, sin embargo, continúa siendo una responsabilidad fundamentalmente humana.
CONFLICTO DE INTERESES
Los autores declaran no presentar conflictos de intereses en relación con la preparación y publicación de este artículo.
RESPONSABILIDAD DE LOS AUTORES
Contribución de los autores: concepción y diseño del estudio, búsqueda y análisis crítico de la literatura, redacción inicial del manuscrito y revisión final (MARL), revisión crítica sustancial del contenido científico, aportaciones metodológicas y supervisión académica del manuscrito (JLAS), apoyo en la revisión bibliográfica, contribución a la discusión ética y revisión final del texto para aprobación de la versión definitiva (APSR).
ABREVIATURAS
AP: Atención Primaria · AUC: área bajo la curva · DL: deep learning · fMRI: resonancia magnética funcional · HCE: historias clínicas electrónicas · IA: inteligencia artificial · ML: machine learning · NLP: natural language processing · RF: random forests · RGPD: Reglamento General de Protección de Datos · RMN: resonancia magnética nuclear · SVM: support vector machines · TEA: trastorno del espectro autista.
BIBLIOGRAFÍA
- Salari N, Rasoulpoor S, Rasoulpoor S, Shohaimi S, Jafarpour S, Abdoli N, et al. The global prevalence of autism spectrum disorder: a comprehensive systematic review and meta-analysis. Ital J Pediatr. 2022;48(1):112. https://doi.org/10.1186/s13052-022-01310-w
- Canals J, Morales-Hidalgo P, Jané MC, Domènech-Llaberia E. ASD prevalence in Spanish school-age children. J Autism Dev Disord. 2020;50(1):175-86. https://doi.org/10.1007/s10803-019-04378-4
- Fuentes J, Canal-Bedia R, Hernández-Fabián A, Magán-Maganto M, Díez-Villoria E, Posada de la Paz M. Prevalencia del trastorno del espectro del autismo en España: datos del estudio ASDEU en Gipuzkoa. Rev Psiquiatr Salud Ment. 2021;14(3):131-8. https://doi.org/10.1016/j.rpsm.2019.12.001
- Zeidan J, Fombonne E, Scorah J, Ibrahim A, Durkin MS, Saxena S, et al. Global prevalence of autism: a systematic review update. Autism Res. 2022;15(5):778-90. https://doi.org/10.1002/aur.2696
- Cavus N, Lawan AA, Ibrahim Z, Dahiru A, Tahir S, Abdulrazak UI, et al. A systematic literature review on the application of machine-learning models in behavioral assessment of autism spectrum disorder. J Pers Med. 2021;11(4):299. https://doi.org/10.3390/jpm11040299
- Reilly A, Walsh N, O’Reilly D, Smyth M, Gorman K, Ostadabbas S, et al. The role of machine learning in autism spectrum disorder assessment and management. Pediatr Res. 2025;98(7):2503-17. https://doi.org/10.1038/s41390-025-04566-0
- Beirat MA, Algolaylat A, Al Njadat H, Al-Abdallat B, Al-Makhzoomy AK. Utilization of artificial intelligence and assistive technology in autism: diagnosis, treatment, and education applications: a systematic literature review. Educ Process Int J. 2025;17:e2025350. https://doi.org/10.22521/edupij.2025.17.350
- Hyman SL, Levy SE, Myers SM; Council on Children With Disabilities, Section on Developmental and Behavioral Pediatrics. Identification, evaluation, and management of children with autism spectrum disorder. Pediatrics. 2020;145(1):e20193447. https://doi.org/10.1542/peds.2019-3447
- Fuentes J, Hervás A, Howlin P; ESCAP ASD Working Party. ESCAP practice guidance for autism: a summary of evidence-based recommendations for diagnosis and treatment. Eur Child Adolesc Psychiatry. 2021;30(6):961-84. https://doi.org/10.1007/s00787-020-01587-4
- Pellicano E, Heyworth M. The foundations of autistic flourishing. Curr Psychiatry Rep. 2023;25(9):419-27. https://doi.org/10.1007/s11920-023-01441-9
- Rutherford M, Johnston L. Rethinking autism assessment, diagnosis and intervention within a neurodevelopmental pathway framework. In: Carotenuto M, editor. Autism Spectrum Disorders: Recent Advances and New Perspectives. London: IntechOpen; 2023. p. 83-91. https://doi.org/10.5772/intechopen.108784
- Cage E, Troxell-Whitman Z. Understanding the reasons, contexts and costs of camouflaging for autistic adults. J Autism Dev Disord. 2019;49(5):1899-911. https://doi.org/10.1007/s10803-018-03878-x
- Abbas H, Garberson F, Glover E, Wall DP. Machine learning approach for early detection of autism by combining questionnaire and home video screening. J Am Med Inform Assoc. 2018;25(8):1000-7. https://doi.org/10.1093/jamia/ocy039
- Zhang S. AI-assisted early screening, diagnosis, and intervention for autism in young children. Front Psychiatry. 2025;16:1513809. https://doi.org/10.3389/fpsyt.2025.1513809
- Magán-Maganto M, Canal-Bedia R, Hernández-Fabián A, Bejarano-Martín Á, Fernández-Álvarez CJ, Martínez-Velarte M, et al. Spanish cultural validation of the Modified Checklist for Autism in Toddlers, Revised. J Autism Dev Disord. 2020;50(7):2412-23. https://doi.org/10.1007/s10803-018-3777-5
- Wieckowski AT, Williams LN, Rando J, Lyall K, Robins DL. Sensitivity and specificity of the Modified Checklist for Autism in Toddlers (original and revised): a systematic review and meta-analysis. JAMA Pediatr. 2023;177(4):373-83. https://doi.org/10.1001/jamapediatrics.2022.5975
- Aishworiya R, Ma VK, Stewart S, Hagerman R, Feldman HM. Meta-analysis of the Modified Checklist for Autism in Toddlers, Revised/Follow-up for screening. Pediatrics. 2023;151(6):e2022059393. https://doi.org/10.1542/peds.2022-059393
- Leroy G, Bisht P, Kandula SM, Maltman N, Rice S. Deep learning for autism detection using clinical notes: a comparison of transfer learning for a transparent and black-box approach. Artif Intell Med. 2026;172:103318. https://doi.org/10.1016/j.artmed.2025.103318
- Vidya S, Gupta K, Aly A, Wills A, Ifeachor E, Shankar R. Identification of critical brain regions for autism diagnosis from fMRI data using explainable AI: an observational analysis of the ABIDE dataset. EClinicalMedicine. 2025;88:103452. https://doi.org/10.1016/j.eclinm.2025.103452
- Sun C, McEwan A, Boulton KA, Demetriou EA, Sadozai AK, Lampit A, et al. Artificial intelligence for tracking social behaviours and supporting an autism spectrum disorder diagnosis: systematic review and meta-analysis. eBioMedicine. 2025;120:105931. https://doi.org/10.1016/j.ebiom.2025.105931
- Das S, Zomorrodi R, Mirjalili M, Kirkovski M, Blumberger DM, Rajji TK, et al. Machine learning approaches for electroencephalography and magnetoencephalography analyses in autism spectrum disorder: a systematic review. Prog Neuropsychopharmacol Biol Psychiatry. 2023;123:110705. https://doi.org/10.1016/j.pnpbp.2022.110705
- Rodeiro-Boliart J, Pérez-Antón M, Olaya B, Huerta-Ramos E, Golobardes E. Artificial intelligence for autism diagnosis: algorithms, data, and challenges. In: Trejo-Banegas K, editor. Artificial Intelligence Research and Development. Amsterdam: IOS Press; 2025. p. 334-43. https://doi.org/10.3233/FAIA250616
- Atturu H, Naraganti S. Effectiveness of AI-driven individualized learning approach for children with autism spectrum disorder (ASD). Eur Psychiatry. 2024;67(Suppl 1):S77. https://doi.org/10.1192/j.eurpsy.2024.205
- Gérvas J, Gavilán Moral E, Jiménez de Gracia L. Prevención cuaternaria: es posible (y deseable) una asistencia sanitaria menos dañina. AMF. 2012;8(6):312-7.
- García Soto L, Castilla Torre E, Sánchez Pina C, Mengual Gil JM. Recomendaciones de «no hacer» en la consulta de Atención Primaria. Rev Pediatr Aten Primaria. 2023;25:293-300. https://doi.org/10.60147/63e6bc52
- Charlton JI. Nothing about us without us: disability oppression and empowerment. Berkeley: University of California Press; 1998.
- Kimhi Y, Mirsky Y, Bauminger-Zviely N. The role of theory of mind, executive functions, and central coherence in reading comprehension for children with ASD and typical development. J Autism Dev Disord. 2025;55:1302-17. https://doi.org/10.1007/s10803-024-06272-y
- Bizzell E, Ross J, Rosenthal C, Dumont R, Schaaf R. Sensory features as a marker of autism spectrum disorders. J Autism Dev Disord. 2020;50(6):2240-6. https://doi.org/10.1007/s10803-019-03948-8
- Hennessy A, Seguin D, Correa S, Wang J, Martínez-Trujillo JC, Nicolson R, et al. Anxiety in children and youth with autism spectrum disorder and the association with amygdala subnuclei structure. Autism. 2023;27(4):1053-67. https://doi.org/10.1177/13623613221127512
- Bölte S. A more holistic approach to autism using the International Classification of Functioning: the why, what, and how of functioning. Autism. 2023;27(1):3-6. https://doi.org/10.1177/13623613221136444
- Jacob S, Wolff JJ, Steinbach MS, Doyle CB, Kumar V, Elison JT. Neurodevelopmental heterogeneity and computational approaches for understanding autism. Transl Psychiatry. 2019;9(1):63. https://doi.org/10.1038/s41398-019-0390-0
- Thabtah F, Peebles D. Early autism screening: a comprehensive review. Int J Environ Res Public Health. 2019;16(18):3502. https://doi.org/10.3390/ijerph16183502
- Okoye C, Obialo-Ibeawuchi CM, Obajeun OA, Sarwar S, Tawfik C, Waleed MS, et al. Early diagnosis of autism spectrum disorder: a review and analysis of the risks and benefits. Cureus. 2023;15(8):e43226. https://doi.org/10.7759/cureus.43226